

30 天 GPU LeetCode 挑戰:從 CUDA 新手到 Kernel Leaderboard
Day 1 把一段 CPU 程式搬上 GPU,Day 2 搞懂 Thread / Block / Grid / Warp 與 SM 的關係。今天要回答的是第一個真正影響效能的問題:
同樣都是讀 GPU memory,為什麼有些 kernel 就是快很多?
這個問題的答案,會決定你之後寫的每一個 kernel。
__syncthreads() 為什麼在 Shared Memory 合作中不能省+1 為什麼有時候就解決了貫穿全文的範例是 Matrix Transpose,因為它是一個很特別的題目:它完全沒有計算,純粹在搬資料。所以量到的效能差異,百分之百來自記憶體存取方式。
比較一下這兩件事:
Matrix Copy         讀 N 個 float,寫 N 個 float,零計算
Matrix Transpose    讀 N 個 float,寫 N 個 float,零計算
搬運量一模一樣,計算量都是零。照理說速度應該一樣。
但我今天在 Tesla T4 上實測,naive transpose 的有效頻寬只有 Matrix Copy 的 34%~73%——取決於 block 形狀。
同樣的資料量、同樣零計算,光是「怎麼存取」就能差到兩倍以上。
同樣的資料量、同樣的零計算,速度卻差這麼多——差別只可能出在「怎麼存取」。這就是今天的主題。
要理解差異,得先修正一個直覺上的誤解。
Thread 0 → 跑去 DRAM 拿 4 bytes
Thread 1 → 跑去 DRAM 拿 4 bytes
Thread 2 → 跑去 DRAM 拿 4 bytes
...
實際上不是。
Day 2 講過,GPU 排程的單位是 Warp:
1 Warp = 32 Threads,lock step 一起前進
記憶體存取也是以 Warp 為單位的。當一個 warp 執行到一行讀取指令時,硬體會一次看完這 32 個 thread 總共要讀哪些位址,然後計算:
要用最少幾個 memory transaction,才能把這些位址全部涵蓋?
而 transaction 有固定大小。在現代的 GPU(Compute Capability 6.0 以上)上,粒度是:
1 transaction = 32 bytes
關鍵在於:transaction 是最小單位。你就算只要其中 4 bytes,硬體還是得把整個 32 bytes 搬過來。
有了上面的基礎,coalescing 就很好理解了。
假設一個 warp 的 32 個 thread 要讀連續的 32 個 float:
Thread  0 → A[0]
Thread  1 → A[1]
Thread  2 → A[2]
...
Thread 31 → A[31]
這 32 個 float 在記憶體裡是連續的,總共佔:
32 threads × 4 bytes = 128 bytes
硬體發現「這 128 bytes 是連續的」,於是合併成:
128 bytes ÷ 32 bytes = 4 個 transaction
        Warp(32 threads)需要 128 bytes
                     │
        ┌──────┬──────┬──────┬──────┐
        │ 32B  │ 32B  │ 32B  │ 32B  │   ← 4 個 transaction
        └──────┴──────┴──────┴──────┘
             搬進來的每一個 byte 都用得到
NVIDIA 官方文件的這張圖畫的就是這件事:
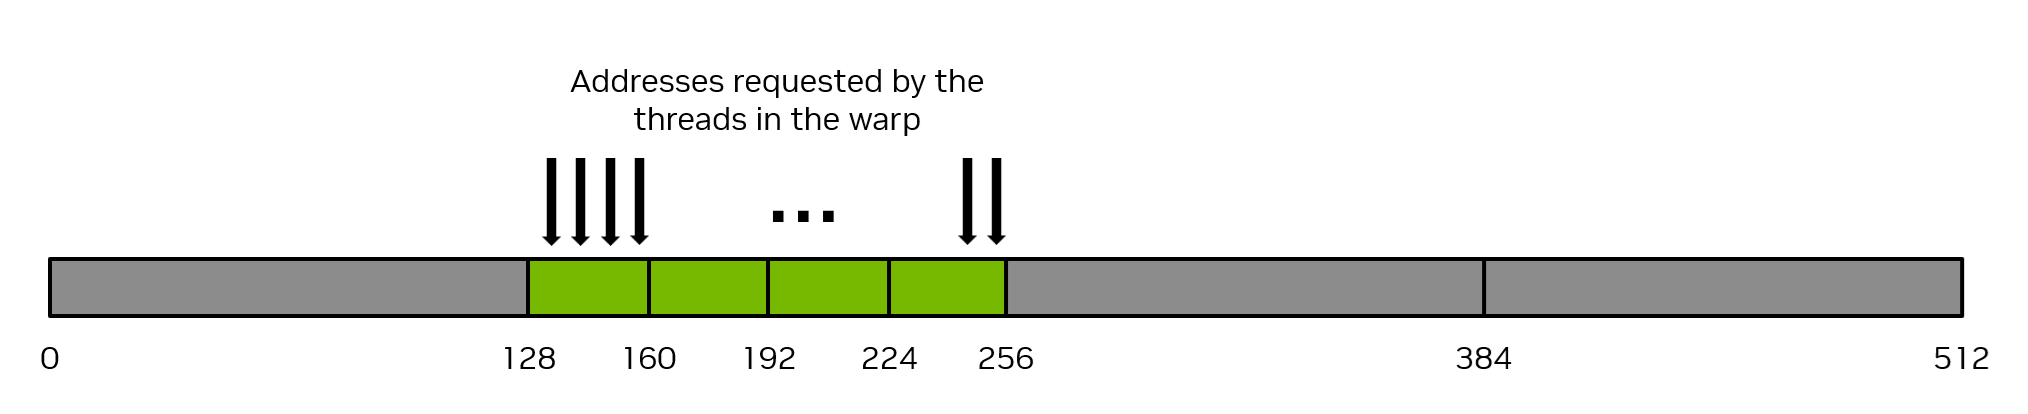
綠色是硬體實際搬回來的區段。整個 warp 的存取都落在 128~256 這個範圍內,
所以只碰到 4 個 32-byte 區段。
圖片來源:CUDA C++ Programming Guide
這個「把多個 thread 的請求合併成少數幾個 transaction」的行為,就叫做:
Memory Coalescing(記憶體合併存取)
搬了 128 bytes,用了 128 bytes。效率 100%。
這是 global memory 存取的最佳狀態,也是後面所有優化的參考點。
上一節的前提是「thread 0 讀 A[0]、thread 1 讀 A[1]」。這個對應關係是我們自己在程式裡決定的:
int index = blockIdx.x * blockDim.x + threadIdx.x;
y[index] = x[index];
這裡有個容易忽略的細節:threadIdx.x 是變化最快的維度。
一個 block 裡的 thread 被編號成 warp 時,順序是:
linear id = threadIdx.z * (blockDim.x * blockDim.y)
          + threadIdx.y *  blockDim.x
          + threadIdx.x

Warp 0 = linear id  0 ~ 31
Warp 1 = linear id 32 ~ 63
...
也就是說,同一個 warp 裡的 thread,threadIdx.x 幾乎都是連續的。
所以規則可以簡化成一句話:
讓位址的計算式,跟著
threadIdx.x連續變動。
threadIdx.x 加 1,位址就加 1 個元素 → coalesced。threadIdx.x 加 1,位址跳了一大段 → 不 coalesced。
這條規則之後會反覆出現。二維問題裡尤其要小心:哪一個維度掛在 threadIdx.x 上,決定了你是快還是慢。
現在看反例。假設一個 warp 這樣讀:
Thread  0 → A[0]
Thread  1 → A[32]
Thread  2 → A[64]
Thread  3 → A[96]
...
每個 thread 之間隔了 32 個 float(128 bytes),這叫 stride。
這 32 個位址,沒有任何兩個落在同一個 32-byte 區段裡。所以硬體沒得合併:
      Warp(32 threads)一樣只需要 128 bytes
                     │
   ┌────┐  ┌────┐  ┌────┐        ┌────┐
   │32B │  │32B │  │32B │  ...   │32B │   ← 32 個 transaction
   └────┘  └────┘  └────┘        └────┘
     ↑       ↑       ↑             ↑
   只用4B  只用4B  只用4B        只用4B
算一下:
搬進來:32 transaction × 32 bytes = 1024 bytes
真正用到:32 threads × 4 bytes    =  128 bytes

有效利用率 = 128 / 1024 = 12.5%
對照官方同一組圖的另一半,差別一目了然:
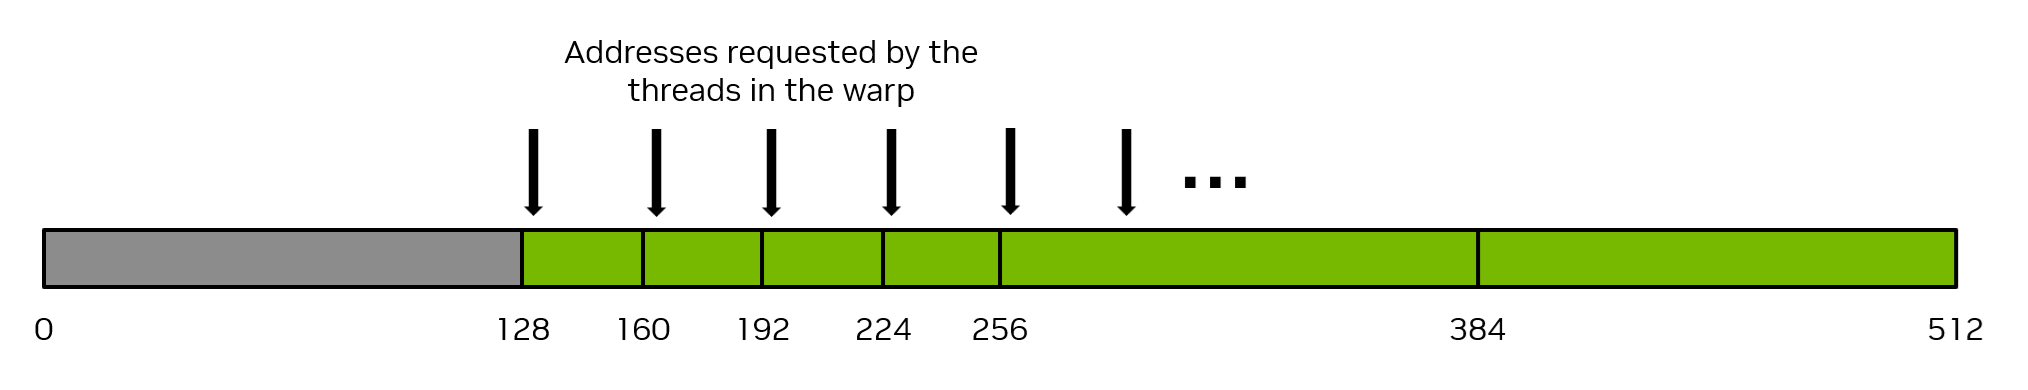
同樣是 32 個 thread、同樣只要 128 bytes,但綠色區段從 128 一路鋪到 512——
搬回來的量是前一張的好幾倍。
圖片來源:CUDA C++ Programming Guide
NVIDIA 也量過 stride 對頻寬的實際影響:
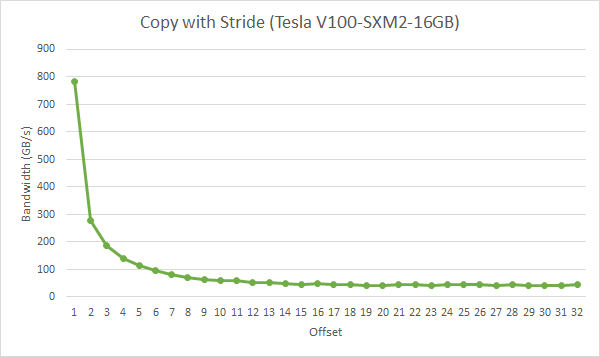
在 Tesla V100 上,stride 從 1 增加到 2,頻寬就從約 780 GB/s 掉到約 280 GB/s;
stride 32 時只剩約 40 GB/s。
圖片來源:CUDA C++ Best Practices Guide
注意這張圖掉得比我上面算的 8 倍還兇——接近 19 倍。因為這是一個純粹的
strided copy 微基準,每個 thread 都跳到完全無關的位置,沒有任何鄰居會來填補
被浪費掉的區段。第 12 節會看到,真實的 transpose 因為有 L2 幫忙,情況比這個好很多。
這才是 strided access 慢的真正原因。
重點不是「跳著讀比較慢」這種模糊的說法,而是:
你請求的資料量沒變,但硬體被迫搬了 8 倍的資料回來,其中 87.5% 直接丟掉。
而 Day 1 最後的結論是 Vector Add 屬於 memory bandwidth bound——瓶頸在頻寬。當頻寬是瓶頸時,浪費頻寬就等於變慢。
但這裡要先打一個預防針:上面算出來的 12.5% 是「最壞情況」,不是實際會量到的數字。
因為這個算法只看了一個 warp。真實的 kernel 有很多 warp 同時在跑,而它們之間還隔著一層 L2 cache。第 12 節會用實測數據說明這個差距有多大——我自己就在這裡預測失準了。
這也解釋了為什麼 NVIDIA 的 Best Practices Guide 把 coalesced access 列為最高優先級的優化項目:它不是錦上添花,它決定你能用到硬體幾成的能力。
先看清楚 transpose 到底在做什麼:
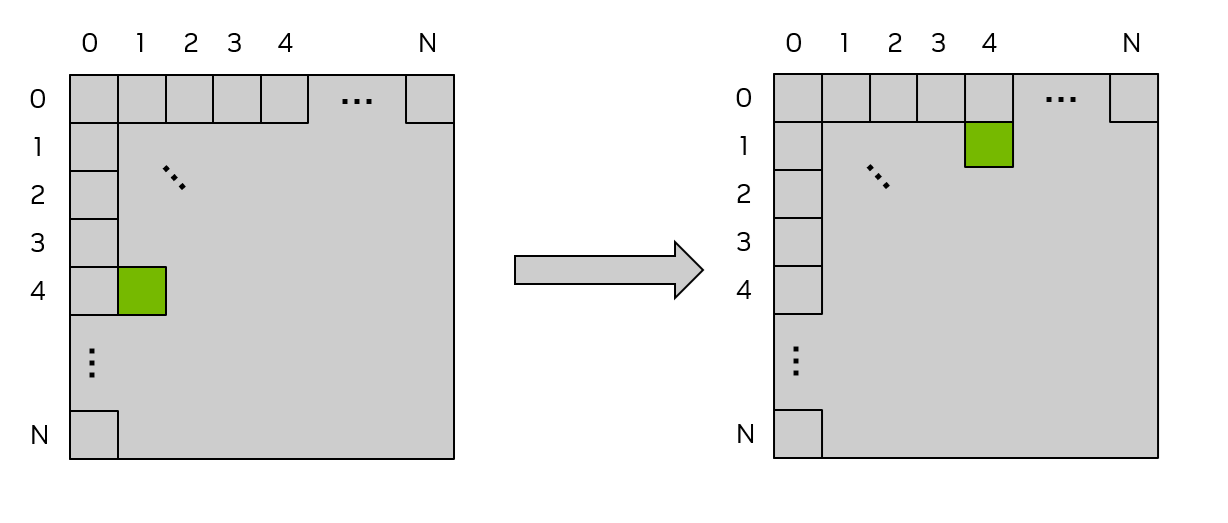
位置 (4, 1) 的元素要搬到 (1, 4)。列變欄、欄變列。
圖片來源:CUDA C++ Programming Guide
這是我今天在 LeetGPU 上寫的版本:
#include <cuda_runtime.h>

__global__ void matrix_transpose_kernel(const float* input, float* output,
                                        int rows, int cols) {
    int x = blockDim.x * blockIdx.x + threadIdx.x; // col
    int y = blockDim.y * blockIdx.y + threadIdx.y; // row

    if (x < cols && y < rows) {
        int input_pixel  = y * cols + x;
        int output_pixel = x * rows + y;
        output[output_pixel] = input[input_pixel];
    }
}

extern "C" void solve(const float* input, float* output, int rows, int cols) {
    dim3 threadsPerBlock(16, 16);
    dim3 blocksPerGrid((cols + threadsPerBlock.x - 1) / threadsPerBlock.x,
                       (rows + threadsPerBlock.y - 1) / threadsPerBlock.y);

    matrix_transpose_kernel<<<blocksPerGrid, threadsPerBlock>>>(input, output,
                                                                rows, cols);
    cudaDeviceSynchronize();
}
這份程式碼是正確的,LeetGPU 也過了。但用第 4 節那條規則檢查一下,會發現一件有趣的事。
先看讀取:
input_pixel = y * cols + x
threadIdx.x 加 1 → x 加 1 → input_pixel 加 1。
位址連續。讀取是 coalesced 的。 ✅
再看寫入:
output_pixel = x * rows + y
threadIdx.x 加 1 → x 加 1 → output_pixel 加了 rows。
位址一次跳 rows 個 float。如果矩陣是 1024×1024,那就是一次跳 4096 bytes。
寫入是 strided 的。 ❌
                讀 input              寫 output

Thread 0  →  ████                  █
Thread 1  →   ████                         █
Thread 2  →    ████                               █
Thread 3  →     ████                                     █
             ↑                        ↑
          連續、可合併            散落各處、無法合併
這就是 naive transpose 慢的地方。
而且它慢得很「不公平」:讀取那一半明明做對了,但只要寫入那一半是 strided 的,整個 kernel 就被拖垮。
還有一個細節值得注意:這個問題沒辦法靠交換索引解決。如果把寫入改成連續的:
int input_pixel  = x * rows + y;   // 讀變成 strided
int output_pixel = y * cols + x;   // 寫變成 coalesced
那就換成讀取 strided 了。轉置這件事本身,就註定有一邊要跳著走。
這是今天最重要的體悟:
問題不在「哪一邊寫錯了」,而在於「兩邊不可能同時連續」。
要解決它,需要一個新工具。
16×16 比 32×8 好?在往下之前,先看一個我原本沒想到的細節。
我用的 block 是 dim3(16, 16)。那麼 warp 0 的 32 個 thread 是誰?
linear id = threadIdx.y * 16 + threadIdx.x

Warp 0 = linear id 0 ~ 31
       = (x = 0~15, y = 0)  和  (x = 0~15, y = 1)
一個 warp 跨了 block 的兩列。
現在算寫入。output_pixel = x * rows + y:
y = 0 這排:  output[ 0*rows ], output[ 1*rows ], ..., output[15*rows ]
y = 1 這排:  output[ 0*rows+1], output[ 1*rows+1], ..., output[15*rows+1]
注意看——output[x*rows] 和 output[x*rows + 1] 是相鄰的兩個 float!
所以這 32 個寫入其實是 16 組、每組 2 個相鄰的 float:
16 個 transaction × 32 bytes = 512 bytes
真正用到 = 128 bytes
有效利用率 = 25%
那如果 block 改成 dim3(32, 8) 呢?warp 0 就是 (x = 0~31, y = 0),完整一列。寫入變成:
output[0*rows], output[1*rows], ..., output[31*rows]
32 個位址、彼此相隔 rows,完全沒有任何兩個相鄰:
32 個 transaction × 32 bytes = 1024 bytes
有效利用率 = 12.5%
結論有點反直覺:
對 naive transpose 來說,
16×16的有效頻寬利用率是32×8的兩倍。
因為 16×16 讓一個 warp 跨兩列,而那兩列在 output 裡剛好是相鄰的。
順著同樣的算法,也可以預測 8×32——warp 0 跨四列,寫入變成 8 組各 4 個相鄰 float:
8 個 transaction × 32 bytes = 256 bytes
有效利用率 = 50%
所以我在跑實測之前,寫下了這組預測:
| block | 一個 warp 跨幾列 | 寫入形態 | 預測有效利用率 |
|---|---|---|---|
32×8 |
1 | 32 個散點 | 12.5% |
16×16 |
2 | 16 組 × 2 個相鄰 | 25% |
8×32 |
4 | 8 組 × 4 個相鄰 | 50% |
block 的形狀不只影響平行度,還直接影響記憶體存取的合併程度。
這個預測後來只對了一半——排序對了,數字全錯。第 12 節會攤開來檢討。
回到第 6 節的死結:讀和寫不可能同時連續。
Shared Memory 之所以能解開這個死結,是因為它改變了問題的形狀。
Day 2 提過記憶體階層:
Register  →  Shared Memory  →  L2 Cache  →  Global Memory
  最快                                          最慢
  1 cycle      數十 cycle                    數百 cycle
Shared Memory 有兩個關鍵特性:
第 2 點是重點。既然「非連續存取」在 shared memory 上便宜得多,那策略就浮現了:
把轉置這個動作,從 global memory 搬到 shared memory 裡做。
流程變成三步:
① 從 global memory 讀一個 tile 進 shared memory
       ← 讀取用連續的方式,coalesced ✅

② 在 shared memory 裡面完成轉置
       ← 這裡跳著存取,但代價很低

③ 從 shared memory 寫回 global memory
       ← 寫入也用連續的方式,coalesced ✅
   Global Memory                 Global Memory
    (input)                        (output)
       │                              ▲
       │ coalesced 讀                 │ coalesced 寫
       ▼                              │
   ┌────────────────────────────────────┐
   │        Shared Memory (tile)        │
   │      轉置發生在這裡,不在 DRAM      │
   └────────────────────────────────────┘
兩邊都 coalesced 了。 代價是中間多一次 shared memory 的來回,但那便宜太多。
程式碼長這樣(明天 Day 4 會實際跑它並量數字):
#define TILE 32

__global__ void transpose_shared(const float* input, float* output,
                                 int rows, int cols) {
    __shared__ float tile[TILE][TILE];

    int x = blockIdx.x * TILE + threadIdx.x;
    int y = blockIdx.y * TILE + threadIdx.y;

    // ① 讀進 tile:x 跟著 threadIdx.x 走 → coalesced
    if (x < cols && y < rows) {
        tile[threadIdx.y][threadIdx.x] = input[y * cols + x];
    }

    __syncthreads();

    // ② 換算成轉置後的座標
    int tx = blockIdx.y * TILE + threadIdx.x;
    int ty = blockIdx.x * TILE + threadIdx.y;

    // ③ 寫出去:tx 也跟著 threadIdx.x 走 → 一樣 coalesced
    //    轉置體現在 tile 的索引交換上
    if (tx < rows && ty < cols) {
        output[ty * rows + tx] = tile[threadIdx.x][threadIdx.y];
    }
}
看懂這段的關鍵在最後一行:
寫入 global:output[ty * rows + tx]      ← tx 跟 threadIdx.x 連動,連續
讀取 shared:tile[threadIdx.x][threadIdx.y]  ← 索引交換,跳著讀
跳著讀的那一次,被挪到 shared memory 裡了。 這就是整個技巧。
__syncthreads() 為什麼不能省?中間那行 __syncthreads() 看起來很不起眼,但拿掉程式就錯了。
原因是:寫進 tile 的 thread,和讀出 tile 的 thread,不是同一個。
寫入時:thread (tx=3, ty=5) 寫 tile[5][3]
讀取時:thread (tx=3, ty=5) 讀 tile[3][5]
                                  ↑
                    這格是 thread (tx=5, ty=3) 寫的
也就是說,每個 thread 讀的都是別人寫的資料。
而 Day 2 講過,同一個 block 裡的 thread 雖然在同一個 SM 上,但它們分屬不同 warp,warp 之間的執行進度是不保證的。可能發生:
時間 →

Warp 0:  寫 tile ──────────→ 讀 tile
Warp 1:          還沒開始寫 ──────→ 寫 tile
                                ↑
                   Warp 0 讀到的是還沒被寫入的垃圾值
__syncthreads() 的作用就是插一道柵欄:
block 裡所有 thread 都執行到這一行之前,誰都不准往下走。
Warp 0:  寫 tile ──┐
Warp 1:  寫 tile ──┤
Warp 2:  寫 tile ──┼── __syncthreads() ──→ 全部一起往下
Warp 3:  寫 tile ──┘
                   ↑
            到這裡,tile 保證是完整的
有兩個延伸的點要記住:
第一,它只同步 block 內部。 跨 block 沒有這種東西——不同 block 可能在不同 SM、甚至不同時間執行,要跨 block 同步只能拆成兩個 kernel。
第二,所有 thread 都必須執行到它。 如果把 __syncthreads() 寫在 if 裡面,而只有部分 thread 進得去,其他 thread 永遠等不到 → 死鎖。
// ✗ 危險:有 thread 進不來就死鎖
if (x < cols) {
    __syncthreads();
}

// ✓ 正確:同步點放在所有 thread 都會經過的地方
if (x < cols) {
    tile[threadIdx.y][threadIdx.x] = input[y * cols + x];
}
__syncthreads();
這也是為什麼第 8 節的程式碼裡,邊界檢查包住的是讀寫,而 __syncthreads() 放在 if 外面。
用了 shared memory,兩邊都 coalesced 了,看起來完美。
但我實測的結果是:這個版本只有 Matrix Copy 的 69.6%,甚至輸給了 naive 8×32 的 73.4%。
用了 shared memory 反而比較慢。問題出在最後一個環節。
還有最後一個問題:Bank Conflict。
Shared memory 不是一塊單一的記憶體,它被切成 32 個 bank:
Bank:   0    1    2    3   ...   31
       ┌──┐ ┌──┐ ┌──┐ ┌──┐      ┌──┐
       │4B│ │4B│ │4B│ │4B│ ...  │4B│
       ├──┤ ├──┤ ├──┤ ├──┤      ├──┤
       │4B│ │4B│ │4B│ │4B│ ...  │4B│
       └──┘ └──┘ └──┘ └──┘      └──┘
連續的 4 bytes 依序落在不同 bank 上,公式是:
bank = (位址 / 4) % 32
也就是說:第 0、32、64、96... 個 float 全都在 bank 0。
規則很簡單:
32 個 bank 可以同時服務 32 個請求。但同一個 bank 一次只能服務一個。
如果一個 warp 的 32 個 thread 剛好落在 32 個不同的 bank → 一次搞定。
如果全部落在同一個 bank → 只能一個一個來,序列化 32 次。
現在來看第 8 節那份程式碼的這一行:
tile[threadIdx.x][threadIdx.y]
tile 宣告成 __shared__ float tile[32][32],所以 tile[i][j] 的位址偏移是 i*32 + j。
一個 warp 裡,threadIdx.y 固定、threadIdx.x 從 0 跑到 31。代進去:
thread  0 → tile[ 0][y] → 偏移  0*32 + y → bank = ( 0*32+y) % 32 = y
thread  1 → tile[ 1][y] → 偏移  1*32 + y → bank = ( 1*32+y) % 32 = y
thread  2 → tile[ 2][y] → 偏移  2*32 + y → bank = ( 2*32+y) % 32 = y
...
thread 31 → tile[31][y] → 偏移 31*32 + y → bank = (31*32+y) % 32 = y
全部都是 bank y。
      Bank 0   Bank 1  ...  Bank y  ...  Bank 31
        空       空            ▲▲▲          空
                          32 個 thread
                          全擠在這裡
官方文件用顏色代表 bank,畫出來是這樣:
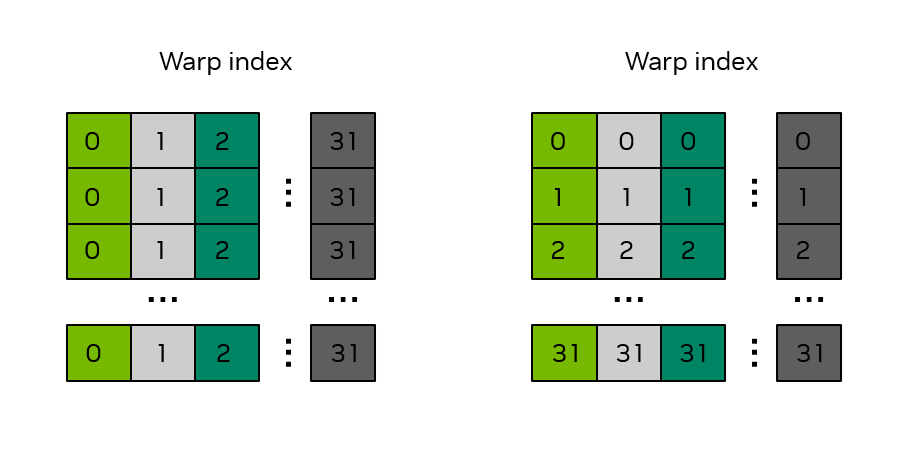
同一個顏色 = 同一個 bank。寬度剛好是 32 時,整個直行都是同一色——
一個 warp 沿著直行讀,就全部撞在同一個 bank 上。
圖片來源:CUDA C++ Programming Guide
這是最糟的情況——32-way bank conflict,這一次存取被拆成 32 次序列化的存取。
原因是 32 這個寬度和 bank 數量 32 剛好一樣,所以「往下一列」等於「回到同一個 bank」。
+1 為什麼有效?解法出乎意料地簡單:
__shared__ float tile[32][33]; // ↑ 就多這個 1
多配一個永遠不會被使用的 column。
重算一次。現在 tile[i][j] 的偏移是 i*33 + j:
thread  0 → tile[ 0][y] → 偏移  0*33 + y → bank = y
thread  1 → tile[ 1][y] → 偏移  1*33 + y → bank = (y + 1)  % 32
thread  2 → tile[ 2][y] → 偏移  2*33 + y → bank = (y + 2)  % 32
thread  3 → tile[ 3][y] → 偏移  3*33 + y → bank = (y + 3)  % 32
...
thread 31 → tile[31][y] → 偏移 31*33 + y → bank = (y + 31) % 32
因為 33 % 32 = 1,所以每往下一列,bank 就往右偏移一格。
32 個 thread 剛好落在 32 個不同的 bank 上:
      Bank 0  Bank 1  Bank 2  Bank 3  ...  Bank 31
        ▲       ▲       ▲       ▲            ▲
        │       │       │       │            │
      t(y)   t(y+1)  t(y+2)  t(y+3)  ...   t(y+31)

              每個 bank 剛好一個 thread
官方的對照圖:
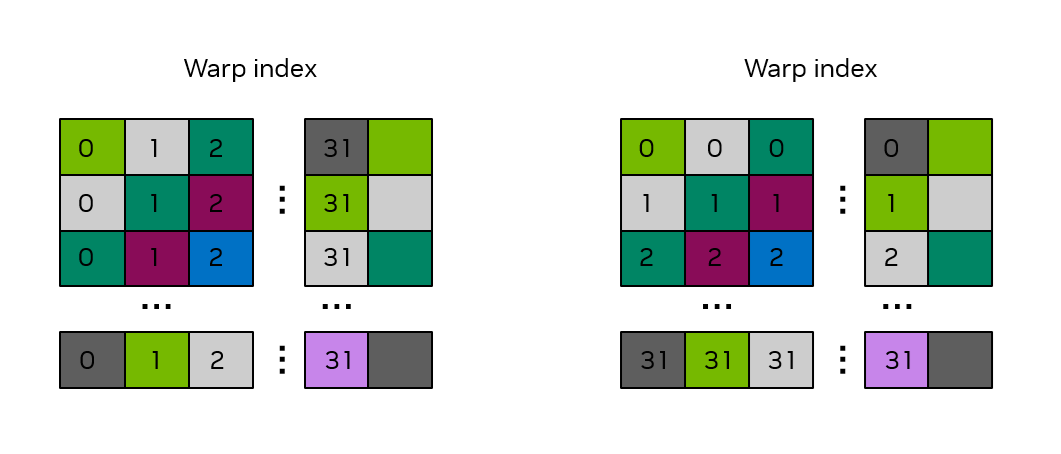
加了 padding 之後顏色變成斜的。同一個直行上不再有重複的顏色,
代表 32 個 thread 落在 32 個不同的 bank。
圖片來源:CUDA C++ Programming Guide
Conflict 完全消失。
代價是多用了 32 × 4 = 128 bytes 的 shared memory——相對於它換來的效能,這幾乎是免費的。
可以把它記成一個通則:
當 shared memory 陣列的「一列寬度」是 32 的倍數時,跨列存取一定會撞在同一個 bank。把寬度改成奇數(通常就是 +1),就能把 bank 錯開。
這就是為什麼你在各種 CUDA 程式碼裡,會一直看到 [32][33]、[16][17] 這種看起來很奇怪的宣告。它們不是筆誤。
而這一個字元的效果,實測是:
Shared Memory            153.5 GB/s   (Copy 的 69.6%)
Shared Memory + Padding  198.9 GB/s   (Copy 的 90.1%)
                         ↑ 1.30 倍
多配 128 bytes 的 shared memory,換來 30% 的效能。
寫到這裡,前面所有推導都還只是紙上談兵。我在 Colab 的 Tesla T4 上把六個版本各跑 100 次取平均,順便在 host 端驗證每個版本的正確性。
GPU        : Tesla T4 (sm_75, 40 個 SM)
理論頻寬   : 320.1 GB/s
矩陣       : 4096 × 4096 float

版本                  時間(ms)   頻寬(GB/s)   對基準線   正確
------------------------------------------------------------
① Copy(基準線)        0.608        220.7     100.0%     ✓
② Naive 16×16           1.280        104.9      47.5%     ✓
③ Naive 32×8            1.779         75.5      34.2%     ✓
④ Naive 8×32            0.829        162.0      73.4%     ✓
⑤ Shared Memory         0.874        153.5      69.6%     ✓
⑥ Shared + Padding      0.675        198.9      90.1%     ✓
先看我預測對的部分:
三種 block 形狀的排序完全正確:
8×32>16×16>32×8。
再看錯的部分:
| block | 我的預測 | 實測 | 差距 |
|---|---|---|---|
32×8 |
12.5% | 34.2% | 2.74 倍 |
16×16 |
25% | 47.5% | 1.90 倍 |
8×32 |
50% | 73.4% | 1.47 倍 |
每一個都被我低估了。而且有個規律:我預測得越糟的版本,低估得越多。
這種系統性的偏差通常代表模型漏了東西,而不是量測有雜訊。
第 5 節那個算法,是站在一個 warp 的角度算的。我假設那個 warp 浪費掉的 transaction 就這樣浪費了。
但實際上,一個 block 裡的所有 warp 是同時在同一顆 SM 上跑的,而且中間還隔著一層 L2 cache。
重新算一次,這次站在 block 的角度。以 16×16 為例,一個 block 負責的寫入範圍是:
x 從 bx*16 到 bx*16+15
y 從 by*16 到 by*16+15

寫入位址 = x * rows + y
固定一個 x,y 掃過 16 個連續值 → output 裡 16 個連續的 float = 64 bytes。
也就是說,warp 0 只寫了其中 2 個,但同一個 block 的另外 7 個 warp 會把剩下的填滿。這些 warp 幾乎同時執行,所以那 64 bytes 在被踢出 L2 之前就寫滿了。
DRAM 看到的不是散點,而是一段一段的連續區塊。三種 block 形狀的差別因此變成:
| block | 一個 block 寫出的連續長度 | 實測 |
|---|---|---|
32×8 |
8 floats = 32 bytes | 34.2% |
16×16 |
16 floats = 64 bytes | 47.5% |
8×32 |
32 floats = 128 bytes | 73.4% |
連續區塊越長,DRAM 效率越高。 排序完全對上了。
所以修正後的結論是:
warp 層級的 transaction 計算給你的是「最壞情況的上限」,不是實際的 DRAM 流量。真正決定效能的,是整個 block 合起來寫出多長的連續區塊。
我原本的模型不算錯——它正確預測了排序,也正確解釋了「為什麼形狀有差」。它只是把 L2 的功勞算成了零。
④ naive 8×32(73.4%)贏過 ⑤ shared memory(69.6%)。
我在寫第 8 節的時候,預設 shared memory 一定比任何 naive 版本好。結果不是。
原因是第 10 節那個 32-way bank conflict:shared memory 的讀取被序列化 32 次,這個懲罰大到把 shared memory 的優勢整個吃掉。一個沒處理 bank conflict 的 shared memory 版本,比不上一個 block 形狀選得好的 naive 版本。
加上 padding 之後(⑥,90.1%)才真正拉開差距。
Shared memory 不是「用了就會變快」的技巧。用錯了會變慢。
這是今天實測給我最大的一課,也是我讀文件時完全沒讀出來的。
今天最重要的一句話是:
GPU 的記憶體效能不取決於你讀了多少資料,而取決於你怎麼讀。
六個問題的答案整理起來:
① 什麼是 memory coalescing?
硬體把一個 warp 的 32 個記憶體請求,合併成最少數量的 32-byte transaction。
② 為什麼相鄰 thread 要存取相鄰資料?
因為 threadIdx.x 是變化最快的維度,同一個 warp 的 lane 對應連續的 threadIdx.x。讓位址跟著它連續變動,硬體才合併得起來。
③ 為什麼 strided access 慢?
不是「跳著讀比較慢」,而是 transaction 是最小單位。stride 拉開後,硬體被迫搬回用不到的資料。不過 warp 層級算出來的 12.5% 是最壞情況的上限——實測是 34.2%,因為 L2 會把同一個 block 各 warp 的寫入合併起來。
④ Shared memory 為什麼能改善 global access?
它把「一定要有一邊不連續」的問題,從 global memory 搬到 shared memory。global 那兩趟都變成 coalesced,不連續的那一次挪到便宜很多的地方做。
⑤ __syncthreads() 為什麼重要?
因為寫 tile 的 thread 和讀 tile 的 thread 不是同一個,而 warp 之間的進度不保證。沒有柵欄就會讀到還沒寫入的資料。
⑥ 什麼是 bank conflict,padding +1 為什麼有效?
shared memory 有 32 個 bank,同一 bank 的存取會序列化。陣列寬度是 32 的倍數時,跨列存取全撞同一個 bank。改成 33(與 32 互質)後每列偏移一格,剛好錯開。
還有兩件是實測才學到、讀文件讀不出來的:
① 真正決定 DRAM 效率的,是整個 block 合起來寫出多長的連續區塊,不是單一 warp 的 transaction 數。
warp 層級的計算給你上限,L2 會把 block 內各 warp 的存取合併起來。我因為忽略這層,把三個版本全部低估了 1.5~2.7 倍。
② Shared memory 不是「用了就會變快」。沒處理 bank conflict 的版本(69.6%),輸給了 block 形狀選得好的 naive 版本(73.4%)。
Day 1 的結論是「Vector Add 是 memory bandwidth bound」。今天把這句話推進了一步:既然瓶頸在頻寬,那優化的核心就是「不要浪費頻寬」——而要知道自己浪費了多少,只能靠量。


 iThome鐵人賽
 看影片追技術